KI Lip-Sync-Generator
Lassen Sie jedes Foto zu Ihrem Audio sprechen.
Laden Sie ein Porträt oder Charakterbild hoch, fügen Sie das gewünschte Audio hinzu und erstellen Sie ein sprechendes Video mit perfekt auf den Ton abgestimmten Lippenbewegungen.
Ein Bild. Eine Audiodatei. Ein sprechendes Video.
Kein Dreh. Kein Gesichts-Rigging. Nutzen Sie einfach das Bild, das Sie bereits haben.
Quellbild
Foto hochladen
Wählen Sie das Gesicht oder den Charakter aus, den Sie animieren möchten.
Verwenden Sie ein klares Porträt, eine Illustration, Charaktergrafik oder ein anderes Bild mit einem gut sichtbaren Gesicht.
Audio
Sprachspur hinzufügen
Laden Sie die Sprache, den Dialog, Gesang oder die Audiospur hoch, die das Bild wiedergeben soll.
Das generierte Video richtet sich nach der Länge Ihrer Audiospur.
Erweiterte Einstellungen
Videoqualität
Eine höhere Qualität kann zu längeren Verarbeitungszeiten führen.
Ihr sprechendes Video erscheint hier.
Laden Sie ein Bild und Audio hoch und starten Sie die Generierung. Ihr Ergebnis öffnet sich auf einer eigenen Seite, sobald es fertig ist.
Bild plus Audio
Bringent Sie ein Foto mit Ihrer eigenen Audiospur zum Sprechen
Sie haben das Bild bereits. Sie haben die Stimme bereits. Der KI Lip-Sync-Generator bringt beides zusammen.
Laden Sie ein Foto, eine Illustration oder ein Charakterbild hoch, fügen Sie die gewünschte Tonspur hinzu und verwandeln Sie das Standbild in ein sprechendes Video – ganz ohne einen neuen Videodreh von Grund auf.
Vom Standbild zum sprechenden Video
Ein statisches Porträt muss nicht statisch bleiben. Nutzen Sie Ihre eigene Sprachaufnahme, Dialoge, Narration oder andere Audiospuren, um das Gesicht zu animieren und synchronisierte Mundbewegungen zu erzeugen.
Ideal, wenn Sie einen sprechenden Charakter, Moderator, Creator-Clip, ein Social-Media-Video oder ein animiertes Porträt benötigen, aber die Performance nicht selbst filmen möchten.
Beispiel
Erleben Sie, wie ein Bild sprechen lernt
Ein einzelnes Standbild und eine Audiodatei wurden zu diesem sprechenden Video kombiniert.
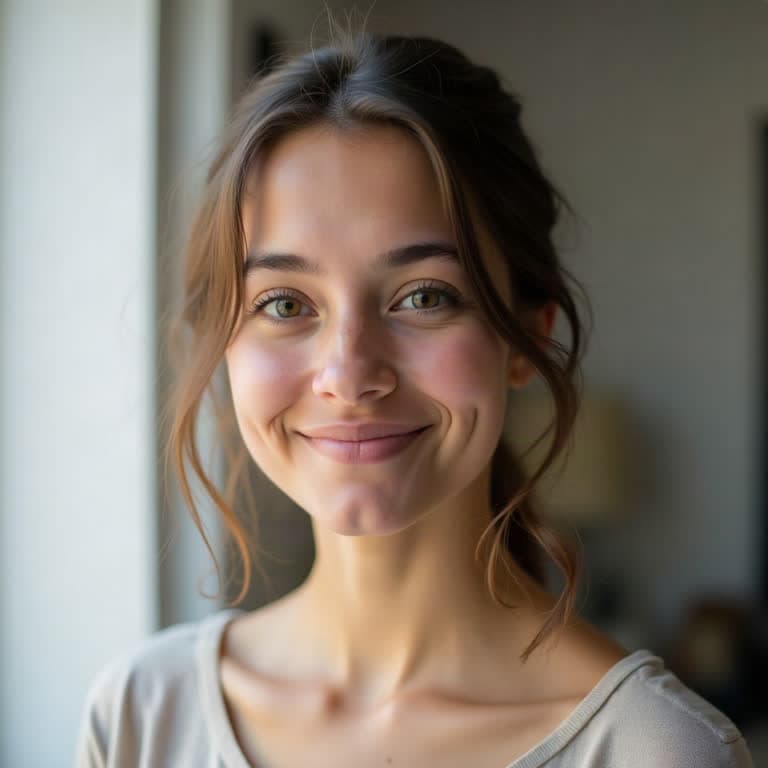 Quellbild
Das Beispielbild und -audio wurden für diese Demonstration mit KI erstellt.
So funktioniert's
In drei Schritten zu einem lippensynchronen Video
- 1
Bild hochladen
Wählen Sie die Person, den Charakter, die Illustration oder das Porträt aus, das Sie animieren möchten.
- 2
Audio hinzufügen
Laden Sie die Sprache oder den Sound hoch, den das Bild wiedergeben soll.
- 3
Video generieren
Die KI animiert das Quellbild und synchronisiert die Mundbewegungen präzise mit Ihrer Audiospur.
Vorteile
Warum KI Lip-Sync nutzen?
Jedes vorhandene Bild verwenden
Verwandeln Sie bestehende Porträts, Charaktergrafiken, Illustrationen und andere Gesichtsbilder direkt in Videos, ohne erst einen neuen Charakter erstellen zu müssen.
Eigene Audiospuren nutzen
Haben Sie die volle Kontrolle darüber, was der Charakter sagt, indem Sie die Audiospur selbst bereitstellen.
Keine Kamera erforderlich
Erstellen Sie einen sprechenden Clip, ohne dass eine Person den Text vor der Kamera aufführen muss.
Schneller mehr Versionen erstellen
Behalten Sie dasselbe Bild bei und testen Sie verschiedene Audio-Clips für neue Botschaften, Sprachen, Werbung, Lektionen oder kreative Variationen.
Anwendungsbereiche
Inhalte aus Ihren bestehenden Bildern erstellen
Sprechende Charaktere
Charaktergrafiken zum Leben erwecken
Verleihen Sie einer illustrierten oder KI-generierten Figur eine Stimme, indem Sie das Artwork mit Dialogen, Narration oder Charakter-Audio verbinden.
Creator-Content
Porträts in sprechende Clips verwandeln
Nutzen Sie ein einzelnes Porträt für kurze, sprechende Videos für Intros, Ankündigungen, Social-Media-Inhalte oder kreative Posts.
Marketing
Sprechende Produkt- oder Markenmaskottchen erstellen
Verwandeln Sie Maskottchen, Markenbotschafter oder Kampagnenfiguren in kurze, sprechende Clips, ohne jede Variation neu filmen zu müssen.
Bildung & E-Learning
Statische Figuren Erklärungen sprechen lassen
Fügen Sie einem Charakter, historischen Porträt, einer Illustration oder einem Lernmaterial eine Sprachspur hinzu, um ein ansprechenderes Erklärvideo zu gestalten.
Lokalisierung
Ein Bild mit unterschiedlichem Audio wiederverwenden
Behalten Sie das Quellbild bei und generieren Sie separate Videos mit verschiedenen Sprachaufnahmen für unterschiedliche Sprachen oder Zielgruppen.
Storytelling
Illustrationen eine Stimme geben
Verwandeln Sie Figuren aus Geschichten, Gemälde, Porträts oder visuelle Konzepte in kurze Sprechszenen.
Funktioniert mit mehr als nur Fotos
Ihre Quelle muss kein echtes Kameraboto sein.
Sie können Porträts, Illustrationen, Charaktergrafiken, 3D-Renderings, Gemälde und andere Bilder mit erkennbaren Gesichtern als Ausgangspunkt nutzen.
Ihr Audio steuert die Performance
Das hochgeladene Audio bestimmt, was der Charakter darstellt. Nutzen Sie gesprochene Dialoge, Narration, Charakterstimmen oder andere Audiospuren je nach gewünschtem Ergebnis.
Bei Sprachaufnahmen kann die Transkriptionshilfe dem Modell dabei helfen, gesprochene Wörter noch genauer bei den Mundbewegungen zu berücksichtigen.
Vorher und Nachher
Wenn Sie das Bild haben, aber keine Aufnahme
Die Aufnahme eines neuen Videos erfordert den Aufwand für Person, Kamera, Beleuchtung, Timing und Performance. KI Lip-Sync ist dann ideal, wenn Sie bereits ein Bild besitzen und lediglich der sprechende Part fehlt.
Bild hochladen. Audio hinzufügen. Clip generieren.
Vorher
- Ein stilles Porträt oder Charakterbild
- Keine Sprechbewegung
- Keine aufgezeichnete Performance
Nachher
- Ein sprechendes Video
- Exakt auf Ihr Audio abgestimmte Mundbewegungen
- Die mitgelieferte Tonspur im finalen Output enthalten
Qualität
Wählen Sie die passende Qualität für Ihr Projekt
Standard
Die praktische Wahl für Social-Media-Inhalte, Vorschauen und alltägliche sprechende Clips.
HD
Mehr Detailreichtum für professionell aufbereitete Creator-Inhalte, Marketing- und Präsentationsvideos.
2K
Hochauflösende Ausgabe für Fälle, in denen es auf jedes visuelle Detail ankommt.
Tipps
So erzielen Sie bessere Lip-Sync-Ergebnisse
- Beginnen Sie mit einem Bild, auf dem das Gesicht klar erkennbar ist.
- Frontale und leicht gedrehte Porträts (Dreiviertelansicht) lassen sich in der Regel einfacher animieren als stark verdeckte Gesichter.
- Verwenden Sie saubere Audiospuren, auf denen die Stimme klar und verständlich zu hören ist.
- Vermeiden Sie Bilder, bei denen der Mund komplett verdeckt, extrem klein oder stark verunstaltet ist.
- Lassen Sie für gesprochene Dialoge die Transkriptionshilfe aktiviert.
Nutzen Sie Bilder und Stimmen, für die Sie die Rechte besitzen
Laden Sie nur Fotos, Charaktergrafiken, Stimmen und Audiodateien hoch, die Ihr Eigentum sind oder für deren Nutzung Sie die entsprechende Erlaubnis haben. Nutzen Sie dieses Tool nicht, um andere Personen zu imitieren, zu täuschen, zu belästigen oder falsch darzustellen.
Häufig gestellte Fragen zum KI Lip-Sync-Generator
Was ist ein KI Lip-Sync-Generator?
Ein KI Lip-Sync-Generator erstellt Mundbewegungen, die einer Audiospur folgen. Mit diesem Tool laden Sie ein Standbild und eine Audiodatei hoch, woraufhin die KI basierend auf beiden Eingaben ein sprechendes Video generiert.
Wie bringe ich ein Foto mit KI zum Sprechen?
Laden Sie das zu animierende Foto hoch, fügen Sie die gewünschte Tonspur hinzu, wählen Sie die Ausgabequalität und starten Sie die Videogenerierung. Die KI animiert das Bild und synchronisiert die Mundbewegungen mit dem bereitgestellten Audio.
Benötige ich ein Video, um den Lip-Sync-Generator zu nutzen?
Nein. Dieses Tool basiert auf einem Standbild. Sie benötigen lediglich ein Bild mit einem sichtbaren Gesicht sowie eine Audiodatei.
Kann ich anstelle eines echten Fotos auch eine Illustration oder Anime-Figur verwenden?
Ja. Das Tool funktioniert mit Fotografien, Illustrationen, Gemälden, Charaktergrafiken und anderen Bildern mit einem erkennbaren Gesicht. Die Ergebnisse können je nach Stil und Sichtbarkeit der Gesichtszüge variieren.
Kann ich meine eigene Audiospur hochladen?
Ja. Ihr hochgeladenes Audio steuert die Lippen-Performance und wird direkt in das generierte Video integriert.
Generiert die KI die Stimme für mich?
Nein. Diese Seite ist auf Ihre bereits vorhandene Audiospur ausgelegt. Laden Sie die Stimme, den Dialog, die Narration oder andere Sounds hoch, die das Bild wiedergeben soll.
Wozu dient die Transkriptionshilfe?
Die Transkriptionshilfe analysiert die gesprochenen Wörter im Audio und verwendet diese als zusätzliches Signal bei der Erstellung der Mundbewegungen. Dies ist besonders für Sprache und Dialoge von Vorteil.
Sollte ich die Transkription bei Gesang deaktivieren?
Sie können die Transkription deaktivieren, wenn es sich bei dem Audio hauptsächlich um Gesang, Musik oder andere Geräusche handelt, die sich nicht sauber transkribieren lassen. In diesem Modus erfolgt die Synchronisation rein über das Audiosignal statt über ein Transkript.
Welche Audioformate kann ich hochladen?
Sie können gängige Formate wie MP3, WAV, M4A, AAC und OGG hochladen. Der Upload-Bereich zeigt Ihnen die unterstützte Länge und Dateigröße an.
Welche Bildformate werden unterstützt?
Sie können Bilder in den Formaten JPG, PNG, WebP, GIF und AVIF hochladen. Extrem schmale oder extrem breite Bilder werden nicht akzeptiert.
Wie lang wird das generierte Video sein?
Das generierte Video richtet sich nach der Dauer der bereitgestellten Audiospur, vorbehaltlich der in der Upload-Schnittstelle angegebenen Limits.
Welche Videoauflösungen stehen zur Verfügung?
Sie können Videos in verschiedenen Qualitätsstufen generieren: Standard, HD und 2K für maximale Details.
Bleibt das Originalbild exakt unverändert?
Das Quellbild bildet die visuelle Grundlage des generierten Videos, aber das Modell muss das Gesicht und umliegende Details animieren, um Bewegung zu erzeugen. Kleine visuelle Abweichungen können auftreten, insbesondere bei komplexen Artworks, ungewöhnlichen Winkeln oder stark verdeckten Gesichtern.
Welche Art von Bild liefert die besten Ergebnisse?
Bilder mit einem klar sichtbaren Gesicht erzielen in der Regel die besten Ergebnisse. Vermeiden Sie extrem kleine Gesichter, starke Verdeckungen des Mundbereichs, extreme Kopfhaltungen oder Bilder, bei denen Gesichtszüge nur schwer zu unterscheiden sind.
Kann ich KI Lip-Sync für kommerzielle Inhalte nutzen?
Sie können das Tool für Inhalte nutzen, zu deren Erstellung Sie berechtigt sind. Stellen Sie sicher, dass Sie über die erforderlichen Rechte oder Genehmigungen für das Bild, die Stimme, das Audio, die Charaktere, Marken und andere hochgeladene Materialien verfügen.
Verleihen Sie Ihrem Bild eine Stimme
Verwandeln Sie ein Foto oder Charakterbild mithilfe eines Audios Ihrer Wahl in ein sprechendes Video.
Entdecken Sie weitere KI-Videotools
KI-Video-Relighting
Passen Sie die Beleuchtung eines bereits gedrehten Videos nachträglich an.
KI-Video-Generator
Erstellen Sie Videos aus Text oder Bildern.
KI-Charakteranimations-Generator
Erwecken Sie Charaktergrafiken als kurzes Video zum Leben.
MiniMax H3 Video-Generator
Erstellen Sie 2K-Videos mit nativem Ton.